Metodologi
AI Slop: Kenapa Kode Cepat Belum Tentu Bagus — dan Cara Kami Menghindarinya
Mengembangkan software tanpa AI slop membutuhkan sistem untuk membuat spec, test, dan menerima setiap perubahan. Generated code masih berupa kandidat sampai evidence mendukung behaviour yang ingin dirilis.
Saya memakai artikel ini untuk menjelaskan pendekatan Synetica: manusia memiliki problem, specification, dan product acceptance; AI menangani task implementasi dengan scope terbatas. Workflow tetap perlu security review, ownership operasional, dan release check sesuai risikonya.
Panduan ini membahas tujuh disiplin, batasan riset produktivitas eksternal, dan hal yang perlu diperiksa klien serta developer. Metodologi ini rekomendasi kami, bukan klaim bahwa semua tim bisa mengulang hasil perusahaan lain.
TL;DR — seluruh panduan dalam lima baris:
- AI slop adalah kegagalan proses, bukan kegagalan model; prompt tanpa struktur menghasilkan software yang sulit di-maintain.
- Blueprint adalah produknya: manusia mendefinisikan masalah, batasan, user flow, dan acceptance criteria sebelum AI menulis kode.
- Context segar mengalahkan context panjang: setiap tugas implementasi masuk ke sesi fokus, bukan satu percakapan yang penuh noise.
- Manusia memvalidasi outcome, bukan review kode baris per baris; AI menangani eksekusi dan review terhadap spec.
- Keuntungan bisnisnya adalah speed dengan kontrol: klien dapat software production lebih cepat karena sistemnya membatasi drift.
Apa itu AI slop dalam software development?
Mari kita jujur soal masalahnya.
AI slop adalah apa yang terjadi kalau kamu generate kode tanpa struktur. Kamu minta ChatGPT buatkan dashboard, hasilnya kelihatan keren, kamu kirim ke production.
Tiga minggu kemudian, customer nemuin bug. Kamu minta AI perbaiki bug-nya.
Malah muncul dua bug baru. Kamu minta perbaiki lagi.
Codebase jadi tumpukan patch di atas patch, yang masing-masing digenerate oleh AI yang nggak ingat kenapa layer sebelumnya ada.
Ini bukan teori. Ini terjadi secara masif sekarang, di seluruh industri.
Biaya rework yang tidak terlihat
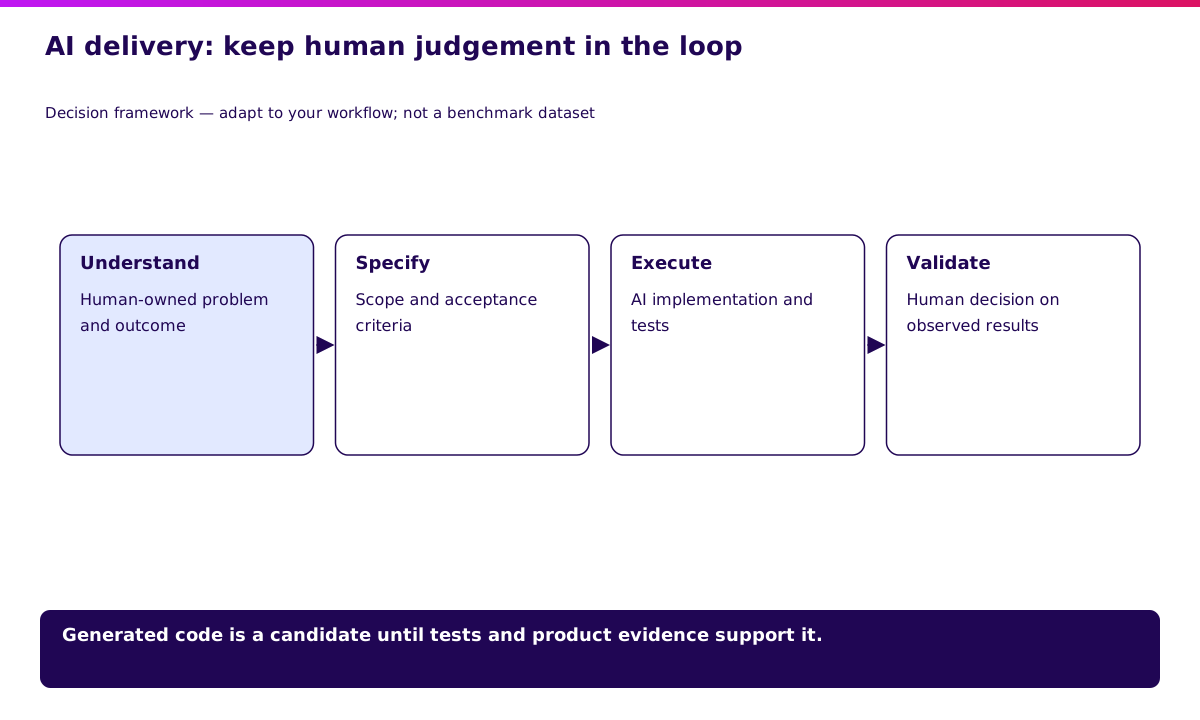 Alur pengembangan Synetica: pemahaman mengalir ke spesifikasi, spesifikasi menggerakkan eksekusi AI, manusia memvalidasi hasilnya — bukan kodenya. Lihat ukuran penuh →
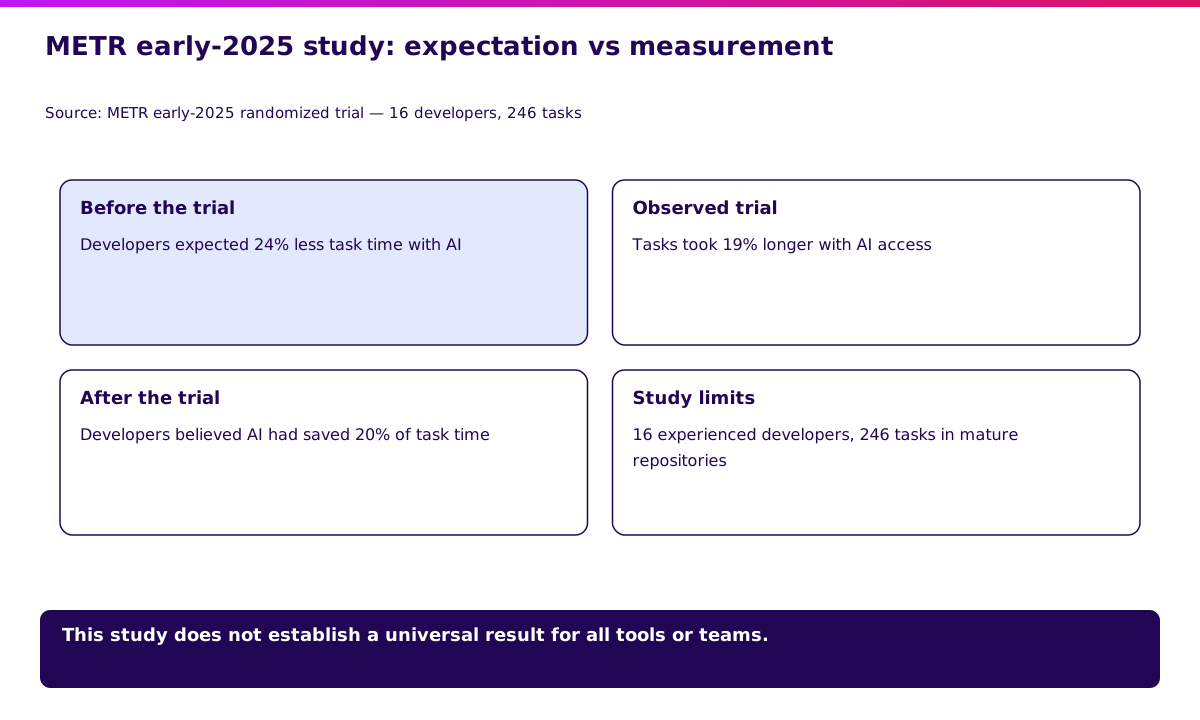
Randomized trial METR pada awal 2025 meneliti 16 developer berpengalaman yang menyelesaikan 246 task pada repository matang. Akses AI menambah waktu penyelesaian 19% pada konteks itu; sebelum trial, peserta memperkirakan pengurangan 24%, lalu setelahnya merasa sudah menghemat 20%.
Temuan ini terbatas pada developer, repository, task, dan tools awal 2025 dalam studi tersebut. Hasilnya tidak membuktikan workflow tanpa struktur menyebabkan slowdown atau semua tim AI lebih lambat. Update METR Februari 2026 menjelaskan selection effect yang menyulitkan pengukuran lanjutan.
Apa yang harus diukur tim delivery AI?
| Sinyal AI slop | Rasanya seperti apa | Biasanya artinya apa | Guardrail |
|---|---|---|---|
| Draft pertama cepat | Layar cepat penuh kode | Requirement masih implisit | Tulis acceptance criteria dulu |
| Bug fix berulang | Setiap patch membuat masalah baru | Model menebak intent | Kembali ke Blueprint |
| Output percaya diri | Jawaban terdengar selesai | Confidence bukan verifikasi | Jalankan test dan pakai produknya |
| Chat history panjang | Assistant seperti ingat semuanya | Context sudah kotor | Pisahkan planning dan eksekusi |
Kok bisa? Karena AI bikin kamu merasa produktif.
Token mengalir. Kode muncul.
Layar terisi. Tapi merasa produktif dan benar-benar produktif itu dua hal berbeda.
AI generate kode dengan cepat, tapi manusianya menghabiskan lebih banyak waktu debug, memahami, dan memperbaiki output AI daripada kalau mereka nulis sendiri dari awal.
Ini jebakan slop. Kecepatan tanpa struktur menghasilkan volume tanpa kualitas.
Bedanya tim AI yang berkualitas
StrongDM menjelaskan Software Factory-nya sebagai proses di mana specification dan scenario memandu agent yang menulis serta memvalidasi code tanpa traditional human code review. Ini penjelasan perusahaan tentang workflow-nya, terpisah dari eksperimen METR.
“Code must not be written by humans.” — StrongDM Software Factory
Desain itu tetap membutuhkan validation harness end-to-end dan manusia yang memutuskan apakah hasilnya layak diterima. Ini contoh untuk diperiksa, bukan bukti bahwa setiap produk harus menghapus human code review.
Jadi pertanyaannya bukan apakah AI bisa menghasilkan kode berkualitas. Jelas bisa.
Pertanyaannya: apa bedanya tim yang kirim kode AI yang bersih dengan tim yang kirim slop?
Jawabannya adalah sistem di sekitar AI-nya, bukan AI-nya sendiri.
Matriks Slop vs Kualitas:
| Struktur Tinggi | Struktur Rendah | |
|---|---|---|
| Pakai AI | ✅ Kualitas di skala besar (Synetica) | ⚠️ AI Slop (vibe coding) |
| Tanpa AI | 🐢 Kualitas tapi lambat (tradisional) | 💥 Kekacauan (cowboy coding) |
Pertanyaannya bukan “haruskah kita pakai AI?” — tapi “apakah kita punya struktur untuk pakai AI dengan benar?”
Bagaimana software development AI menghindari slop? Tujuh disiplin
Kami nggak menyebutnya “aturan” atau “best practice.” Kami menyebutnya disiplin, karena memang itu yang dibutuhkan. Masing-masing adalah pilihan sadar untuk melambat di momen tertentu supaya keseluruhan proses berjalan lebih cepat dan menghasilkan output yang lebih baik.
Disiplin 1: Spesifikasi Adalah Produknya
Ini fondasi dari semua yang kami kerjakan di Synetica. Datang dari keyakinan yang sudah saya pegang selama 15 tahun tapi baru bisa dieksekusi sekarang: nilai di pengembangan software itu bukan pernah di coding-nya.
Selalu di memahami masalahnya.
Saya menulis ini dengan detail di “Kode Bukan Lagi Intinya.” Versi pendeknya: selama satu dekade, industri software Indonesia (dan jujur, global) mengenakan tarif ke klien untuk jam kerja developer. Enam orang, enam bulan, seratus juta rupiah.
Tapi sebagian besar nilainya terdelivery di dua minggu pertama — saat seseorang benar-benar duduk dan memahami apa yang klien butuhkan.
Lima setengah bulan sisanya? Itu proses building.
Lambat. Dengan miskomunikasi.
Dengan requirement yang bergeser. Dengan code review yang menangkap syntax tapi luput menangkap intent.
AI baru saja membuat proses building itu gratis. Artinya satu-satunya hal yang layak dibayar adalah pemahamannya.
Isi Blueprint yang sebenarnya
Di Synetica, kami menangkap pemahaman itu dalam apa yang kami sebut Blueprint — spesifikasi komprehensif yang cukup detail untuk AI agent bangun tanpa ambiguitas. (Blueprint yang sama yang jadi jangkar layanan Blueprint & Prototype kami, dan metodologinya kami dokumentasikan terpisah.) Blueprint mencakup:
- Masalah yang sebenarnya — bukan apa yang klien minta, tapi apa yang mereka benar-benar butuhkan. Ini seringkali berbeda. Klien bilang “kami butuh CRM.” Yang sebenarnya mereka butuhkan adalah cara supaya lead nggak hilang antara sales call dan follow-up karena tiga departemen nggak saling bicara. (Pola kegagalan yang sama kami bedah di kenapa proyek transformasi digital gagal di perusahaan yang sedang tumbuh.)
- Batasan sistem — apa yang masuk scope, apa yang eksplisit di luar scope, dan apa yang jadi change request di masa depan. Ini kritis karena AI agent dengan senang hati akan membangun hal yang nggak kamu minta kalau kamu nggak bilang jangan.
Mengubah intent menjadi constraint yang bisa diuji
- Arsitektur data — entitas, relasi, constraint, aturan validasi. Bukan sketsa kasar. Spesifikasi presisi yang nggak menyisakan ruang bagi AI untuk berasumsi.
- User flow — langkah per langkah, termasuk edge case yang merusak kebanyakan software. Apa yang terjadi kalau user memasukkan data yang nggak valid? Apa yang terjadi kalau dua user mencoba approve hal yang sama secara bersamaan? Apa yang terjadi kalau koneksi putus?
- Kriteria penerimaan — kondisi yang bisa diukur dan diuji untuk “selesai.” Bukan “harusnya jalan.” Tapi “ketika user submit form dengan data valid, sistem harus menyimpan record dan redirect ke dashboard dalam 2 detik.”
- Strategi testing — apa yang ditest, bagaimana, dan kapan. Ini bukan tambahan di akhir. Ini bagian dari spec.
Kenapa ini membayar balik
Specification yang jelas membuat behaviour yang dituju bisa direview sebelum implementasi. Tes manfaatnya terhadap baseline rework kamu sendiri.
Disiplinnya: Nggak ada kode yang di-generate sampai Blueprint-nya selesai. Tanpa pengecualian. Kalau spec-nya masih bolong, kami kembali ke klien, bukan ke AI.
Disiplin 2: Rencanakan Besar, Eksekusi Segar
Ini disiplin teknis yang paling berdampak dalam praktik kami, dan datang dari observasi sederhana tentang cara kerja model AI.
Sesi panjang bisa mencampur keputusan lama, code yang tidak relevan, dan task sekarang. Saya akan menyimpan specification serta handoff note yang disepakati, lalu memberi setiap task implementasi hanya context yang dibutuhkan untuk menyelesaikan dan memverifikasinya.
Evidence yang dikutip di sini tidak menetapkan threshold universal “50% context”. Ukur failure pada task kamu sendiri, lalu cek apakah memecah task memperbaiki kualitas penyelesaian dan effort review.
Cara kerja eksekusi context segar
Begini cara kami menerapkannya:
Fase 1: Perencanaan (satu sesi mendalam) Kami load Blueprint, diskusikan arsitektur, buat keputusan desain, dan menghasilkan task breakdown terstruktur. Sesi ini boleh panjang — 80K, 90K, bahkan 100K token nggak masalah karena kami sedang berpikir, bukan coding. Output sesi ini adalah dokumen rencana tugas.
Fase 2: Eksekusi (banyak sesi segar) Setiap tugas dari rencana mendapat sesi segar sendiri. AI hanya menerima tiga hal: bagian Blueprint yang relevan, kode existing yang relevan, dan deskripsi tugasnya. Tidak ada lagi. Tidak ada riwayat tugas sebelumnya. Tidak ada obrolan tentang cuaca. Hanya context yang bersih dan terfokus.
| Pilihan context | Cocok untuk | Risiko kalau salah pakai | Aturan Synetica |
|---|---|---|---|
| Sesi planning panjang | Arsitektur, trade-off, urutan task | Mulai implementasi dengan noise lama | Export plan, lalu stop |
| Sesi task segar | Eksekusi fokus | Code context penting terlewat | Load file yang benar-benar perlu |
| Sesi review | Kritik independen | Sekadar menyetujui builder | Pakai context reviewer terpisah |
| Sesi handoff | Dokumentasi dan QA | Jejak keputusan hilang | Link balik ke section Blueprint |
Ini kontra-intuitif. Kebanyakan orang berpikir menjaga AI di satu sesi panjang memberinya “lebih banyak context” dan karenanya hasil yang lebih baik.
Kenyataannya kebalikannya. AI yang terfokus dengan 20K token context relevan mengalahkan AI yang terdistraksi dengan 90K token context campuran setiap saat.
Disiplinnya: Perencanaan dan eksekusi terjadi di sesi terpisah. Setiap tugas implementasi dimulai dengan context window yang segar. Tanpa pengecualian.
Disiplin 3: Test Dulu, Baru Kode (Dan AI yang Nulis Dua-duanya)
Test-driven development sudah dikhotbahkan selama puluhan tahun. Kebanyakan tim masih nggak melakukannya.
Alasannya karena menulis test itu membosankan, dan developer — karena manusia — secara alami tertarik ke pekerjaan yang menarik (menulis fitur) dan menjauhi pekerjaan yang membosankan (menulis test).
AI nggak punya bias ini. AI dengan senang hati menulis test seharian.
Framework Superpowers, yang semakin populer di komunitas Claude Code dan Cursor, memformalkan ini jadi urutan yang ketat:
1. Baca spec → 2. Generate test dari spec → 3. Tulis kode untuk lulus test → 4. Verifikasi test lulus → 5. Cek ulang terhadap rencana awalInsight kritis ada di langkah 2: AI menulis test langsung dari spesifikasi, sebelum menulis kode implementasi apa pun. Ini berarti test-nya merefleksikan apa yang seharusnya terjadi menurut spec, bukan apa yang kebetulan dilakukan kode. Bedanya antara “apakah kode ini jalan?” dan “apakah kode ini melakukan apa yang kita spesifikasikan?”
Loop plan-verify
Langkah 5 mengecek implementasi terhadap acceptance criteria awal. Setelah setiap tugas implementasi, AI kembali ke rencana awal dan memverifikasi bahwa kode-nya cocok dengan kriteria sukses yang didefinisikan di tahap perencanaan.
Ini menangkap failure mode paling umum di pengembangan berbantuan AI: plan drift. Agent bisa menghasilkan pekerjaan yang terlihat masuk akal tetapi bergeser dari kriteria yang disepakati. Review setiap task selesai terhadap requirement awal.
Loop plan-verify menangkap ini sebelum menumpuk.
Di Synetica, kami pakai flow ini persis. Setiap fitur punya test yang di-generate dari Blueprint sebelum satu baris kode implementasi ada.
Test-test ini adalah kontrak antara spec dan kode. Test yang lolos memberi evidence untuk kasus yang dicakup; hasilnya belum membuktikan spec atau implementasi sudah lengkap.
Kalau nggak, kami langsung tahu.
Disiplinnya: Test selalu di-generate sebelum kode implementasi. Setelah setiap tugas, AI memverifikasi output-nya terhadap rencana awal. Tidak ada implementasi yang berjalan tanpa verifikasi ini.
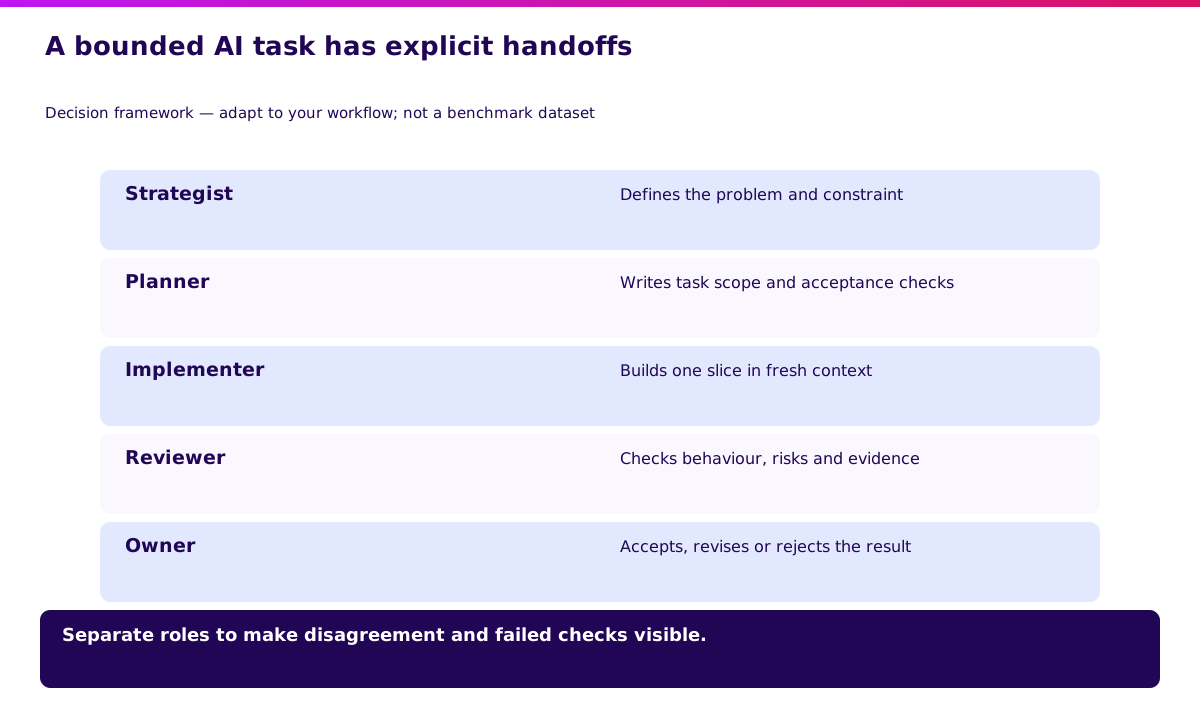 Urutan lengkap: Product Strategist menulis spec → AI generate test → AI bangun kode → AI review → Manusia memvalidasi produknya (bukan kodenya). Lihat ukuran penuh →
Disiplin 4: Model yang Tepat untuk Pekerjaan yang Tepat
Nggak semua model AI itu sama. Menggunakan model yang salah untuk tugas yang salah adalah salah satu jalan tercepat menuju slop — dan salah satu yang paling jarang dibahas.
Evaluasi kandidat model memakai task representatif dan acceptance criteria yang sama. Catat correctness, requirement yang terlewat, latency, biaya, serta pekerjaan review yang tersisa untuk manusia.
Hasil bagus pada satu prompt audit belum menentukan model terbaik untuk planning, implementasi, atau product acceptance. Ulangi evaluasi ketika model, akses tool, atau distribusi task berubah.
Mencocokkan kekuatan model dengan bentuk tugas
Begini cara kami mengalokasikan model di Synetica:
Spesifikasi dan arsitektur: Opus 4.6 atau setara. Tugas-tugas ini membutuhkan nuansa, penanganan ambiguitas, pemahaman context yang dalam, dan kemampuan bernalar tentang tradeoff. Di sinilah model termahal membuktikan nilainya.
Code generation: Codex (GPT-5.3) atau Claude Code. Model-model ini dirancang khusus untuk produksi kode dan sudah dilatih spesifik pada workflow pengembangan. Mereka bukan yang terbaik dalam berpikir — tapi yang terbaik dalam membangun.
Code review dan auditing: Sonnet 4.6 atau GPT-5.2 Low. Tugas prosedural, berbasis checklist. Scan codebase ini dan tandai masalah keamanan, anti-pattern performa, dan inkonsistensi. Model-model ini cepat, murah, dan surprisingly teliti untuk tugas pattern-matching.
Bug fixing dan iterasi: Codex atau Claude Code dengan tool access. Yang dibutuhkan adalah kemampuan membaca file, menjalankan test, dan iterasi — bukan kemampuan deep reasoning.
Prinsipnya: model pintar yang nulis prompt, model yang tepat yang mengeksekusi. Model termahalmu harus mengerjakan thinking-nya. Model eksekusimu harus mengerjakan building-nya. Pakai Opus untuk semua hal itu seperti membayar CEO untuk masukin amplop.
Disiplinnya: Setiap tugas diassign ke model yang paling cocok untuk tipe tugas itu. Kami punya panduan alokasi model yang diikuti tim.
Disiplin 5: Potongan Kecil, Ledakan Kecil
Setiap AI developer berpengalaman akhirnya sampai pada kesimpulan yang sama: tugas yang lebih kecil menghasilkan output yang lebih baik.
Addy Osmani mengatakannya dengan jelas: “LLM bekerja paling baik kalau dikasih prompt yang terfokus — implementasi satu fungsi, perbaiki satu bug, tambahkan satu fitur per saat.”
Panduan best practice resmi Cursor, yang baru dirilis, menggemakan hal ini: perbedaan antara developer AI yang produktif dan yang menghasilkan slop adalah perencanaan dan dekomposisi tugas. Vibe coder langsung terjun dan mulai lempar prompt.
Developer yang efektif memecah pekerjaan jadi tugas-tugas yang terfokus dan independen.
Ini bukan cuma soal kualitas AI. Ini soal blast radius.
Kalau kamu minta AI “bangun seluruh sistem autentikasi,” dan dia membuat keputusan arsitektur yang salah di 50 baris pertama, keputusan itu menyebar ke setiap baris kode setelahnya. Waktu kamu menemukan kesalahannya, itu sudah tertanam di 2.000 baris di 15 file.
Memperbaikinya berarti regenerate semuanya.
Kalau kamu minta AI “implementasi validasi form login,” dan dia membuat keputusan yang salah, kamu kehilangan 50 baris. Kamu buang, perjelas spec-nya, dan regenerate.
Dua menit, bukan dua jam.
Aturan ukuran task
Aturan ukuran tugas kami:
- Satu tugas = satu fitur, satu fungsi, atau satu perbaikan
- Setiap tugas punya input yang jelas (bagian dari Blueprint) dan output yang jelas (kode jalan + test lulus)
- Setiap tugas berjalan di context segar sendiri (lihat Disiplin 2)
- Jangan pernah minta AI “bangun semuanya” — meskipun dia bilang bisa
Potongan kecil juga memungkinkan paralelisme. Kalau kamu punya lima fitur independen yang harus dibangun, kamu bisa menjalankan lima sesi AI terpisah secara bersamaan, masing-masing mengerjakan satu fitur dengan fokus penuh.
Disiplinnya: Setiap tugas implementasi di-scope ke unit pekerjaan terkecil yang bermakna. Setiap tugas berjalan secara independen. Paralelisme lebih disukai daripada sesi besar yang berurutan.
Disiplin 6: AI Review AI (Manusia Review Produknya)
Ini disiplin yang paling membingungkan orang ketika mereka dengar “zero code review.”
Kami pasti review. Kami cuma nggak review kode.
Ini bedanya:
Code review tradisional: Seorang developer manusia membaca setiap baris kode yang ditulis developer lain. Mereka memeriksa syntax error, bug logika, kerentanan keamanan, masalah performa, dan pelanggaran style. Ini makan waktu, nggak konsisten (manusia melewatkan hal), dan nggak bisa di-scale.
Apa bedanya product review?
Proses review kami:
Langkah 1: AI Agent A generate kode dari spec (misal Codex)
Langkah 2: AI Agent B review kode-nya (misal CodeRabbit, Sonnet, atau sesi Claude terpisah)
Langkah 3: AI Agent B menandai masalah → AI Agent A memperbaiki
Langkah 4: Automated test jalan (yang di-generate di Disiplin 3)
Langkah 5: Manusia menggunakan produknya dan memvalidasi terhadap Blueprint
Manusia nggak pernah membaca kode-nya. Manusia menggunakan produknya dan bertanya: “Apakah ini melakukan apa yang kita spesifikasikan?
Apakah ini menyelesaikan masalah klien?”
Ini pertanyaan yang secara fundamental berbeda dari “Apakah kode ini bersih?” Kode bersih yang menyelesaikan masalah yang salah lebih buruk daripada kode berantakan yang menyelesaikan masalah yang benar. Fokus kami pada outcome, bukan implementasi.
Layer review AI-ke-AI menangkap masalah teknis:
- Kerentanan keamanan (SQL injection, XSS, authentication bypass)
- Anti-pattern performa (N+1 query, memory leak, re-render yang nggak perlu)
- Masalah dependency (paket yang outdated, konflik lisensi, risiko supply chain)
- Pelanggaran arsitektural (kode yang nggak mengikuti pattern yang ditetapkan di spec)
- Error logika (edge case, off-by-one error, null reference bug)
AI sebenarnya lebih baik daripada manusia di kebanyakan pengecekan ini. Lebih teliti (nggak pernah capek), lebih konsisten (memeriksa hal yang sama setiap kali), dan lebih cepat (bisa review ribuan baris dalam hitungan detik).
Yang AI TIDAK bagus adalah judgment. Apakah fitur ini benar-benar menyelesaikan masalah user?
Apakah ini tradeoff yang tepat? Apakah klien akan memahami interface ini?
Ini pertanyaan manusia, dan dijawab dengan menggunakan produknya, bukan membaca kodenya.
Disiplinnya: Kode di-review oleh AI agent, nggak pernah oleh manusia. Manusia review produknya terhadap spesifikasi. Kualitas teknis diotomasi. Kualitas produk itu urusan manusia.
Pembagian Ownership Review
| Lapisan review | Reviewer | Yang dicek | Bukti yang dibutuhkan |
|---|---|---|---|
| Static checks | Tooling | Syntax, type, lint, formatting | Output command bersih |
| Automated tests | Test suite dari AI | Acceptance criteria dari Blueprint | Test run lulus |
| Kritik kode | AI reviewer terpisah | Security, performance, architecture drift | Temuan actionable atau clean report |
| Validasi produk | Strategist manusia | Workflow fit, clarity user, outcome bisnis | Produk dipakai melawan Blueprint |
Disiplin 7: Spec Adalah Kontrak yang Hidup
Blueprint nggak mati setelah kode di-generate. Ia tetap jadi kontrak yang hidup sepanjang lifecycle proyek.
Kebanyakan tim development memperlakukan spec sebagai dokumen pembuka — berguna di awal, semakin tidak relevan seiring development berjalan. Pada saat proyek rilis, spec dan kode sudah menyimpang begitu jauh sehingga spec-nya pada dasarnya fiksi.
Menjaga spec dan code tetap selaras
Kami mencegah ini dengan menjadikan Blueprint sebagai dokumen referensi di setiap tahap:
Selama development: Setiap tugas merujuk bagian spesifik dari Blueprint. AI diinstruksikan: “Implementasi bagian 3.2 dari Blueprint.” Setelah implementasi, AI ditanya: “Apakah implementasi ini memenuhi kriteria penerimaan di bagian 3.2?” Ini menciptakan rantai yang bisa dilacak dari spec ke kode.
Selama review: AI reviewer memeriksa kode terhadap Blueprint, bukan hanya terhadap best practice umum. “Spec mengatakan endpoint ini harus mengembalikan hasil yang dipaginasi dengan maksimum 50 item per halaman. Verifikasi bahwa ini diimplementasi dengan benar.”
Validasi dan handoff
Selama validasi: Tester manusia menggunakan kriteria penerimaan dari Blueprint sebagai checklist. Apakah fiturnya memenuhi setiap kriteria? Kalau ya, kirim. Kalau nggak, gap-nya diidentifikasi dan dikirim balik untuk rework.
Selama maintenance: Enam bulan kemudian, kalau ada bug report atau permintaan perubahan, langkah pertama selalu membaca Blueprint. Apa intent aslinya? Apa constraint-nya? Context ini esensial supaya AI bisa membuat perbaikan yang terarah, bukan patch yang buta.
Selama handoff: Ketika proyek diserahkan ke klien, Blueprint adalah bagian dari deliverable. Itu dokumentasinya. Bukan auto-generated API docs. Bukan komentar kode. Spesifikasi aktual yang menjelaskan kenapa setiap keputusan dibuat.
Ini yang membuat pendekatan kami sustainable. Kode tanpa spec adalah kotak hitam.
Kode dengan spec adalah sistem yang bisa kamu pahami, modifikasi, dan maintain — entah yang mengerjakan selanjutnya itu manusia atau AI.
Perbandingan Development Tradisional vs Berbasis Spec:
| Development Tradisional | Development Berbasis Spec (Synetica) |
|---|---|
| Requirement samar | Blueprint presisi dengan kriteria penerimaan |
| Manusia nulis kode | AI generate kode dari spec |
| Manusia review kode baris per baris | AI review kode secara otomatis |
| Test ditambah belakangan (kalau ada) | Test di-generate SEBELUM kode |
| Spec dan kode menyimpang seiring waktu | Spec adalah kontrak yang hidup |
| Knowledge hidup di kepala developer | Knowledge hidup di Blueprint |
| Sulit di-maintain setelah handoff | Siapa pun (manusia atau AI) bisa maintain |
Disiplinnya: Blueprint dijaga sepanjang lifecycle proyek. Setiap implementasi, review, dan validasi merujuk spec-nya. Spec dan kode tidak boleh dibiarkan menyimpang.
Kenapa Ini Berhasil (Pola yang Lebih Dalam)
Kalau kamu melihat tujuh disiplin ini sebagai sebuah sistem, ada pola yang lebih dalam:
**Manusia yang memahami. AI yang membangun.
Spec yang menghubungkan.**
Manusia memahami masalah           → Blueprint
AI generate test dari Blueprint    → Test suite
AI generate kode dari Blueprint    → Implementasi
AI review kode terhadap Blueprint  → Quality check
Manusia validasi produk vs Blueprint → Verifikasi akhir
Spec adalah jembatan antara pemahaman manusia dan eksekusi mesin. Ini layer translasi yang memastikan apa yang dipahami manusia dan apa yang dibangun AI itu hal yang sama.
Tanpa jembatan itu, kamu dapat slop. AI membangun sesuatu yang terlihat masuk akal tapi nggak cocok dengan yang sebenarnya dibutuhkan klien.
Developer nggak menangkapnya karena mereka review kode, bukan outcome. Klien mendapat sesuatu yang secara teknis jalan tapi nggak menyelesaikan masalah mereka.
Dengan jembatan itu, kamu dapat alignment. Setiap keputusan bisa dilacak ke spesifikasi.
Setiap baris kode ada karena alasan yang terdokumentasi di Blueprint. Setiap test memvalidasi sesuatu yang klien katakan mereka butuhkan.
Validasi dalam 2 minggu. Sesi Blueprint mengubah pemikiran ini jadi prototype yang diuji ke user nyata — lihat cara kerja Blueprint & Prototype.
Harga dari TIDAK Melakukan Ini
Saya mau langsung saja soal apa yang terjadi kalau kamu melewati disiplin-disiplin ini.
Saya sudah lihat. Kita semua sudah lihat.
Sebuah tim mengadopsi AI coding tools, produktivitas melonjak dua minggu pertama, lalu sesuatu berubah. Codebase jadi lebih susah dinavigasi.
Bug mulai muncul di bagian kode yang nggak disentuh siapa pun belakangan ini. Tim menghabiskan lebih banyak waktu debug kode AI daripada kalau mereka nulis manual.
Biayanya nyata:
Utang teknis menumpuk tanpa terlihat. Kode AI yang “jalan” tapi nggak di-spec atau di-test dengan benar jadi fondasi untuk fitur-fitur selanjutnya. Setiap layer kode tanpa spesifikasi membuat layer berikutnya lebih susah dibangun dengan benar.
Kepercayaan klien terkikis. Kalau bug muncul di production, kalau fitur nggak sesuai ekspektasi, kalau perubahan memakan waktu lebih lama dari seharusnya — klien kehilangan kepercayaan.
Tim-nya burnout. Debug kode yang nggak kamu tulis dan nggak kamu pahami itu melelahkan. Lebih buruk dari nulis kode dari awal karena kamu harus pertama memahami apa yang AI coba lakukan, lalu cari tahu di mana salahnya, lalu perbaiki tanpa merusak hal lain.
Lanjut: Bagaimana Menilai Ownership Development AI.
Bagaimana Menilai Ownership Development AI
Ini framework editorial untuk mereview tanggung jawab, bukan standar industri atau ranking risiko terukur. Automation yang lebih banyak tidak otomatis membuat sistem lebih baik atau aman.
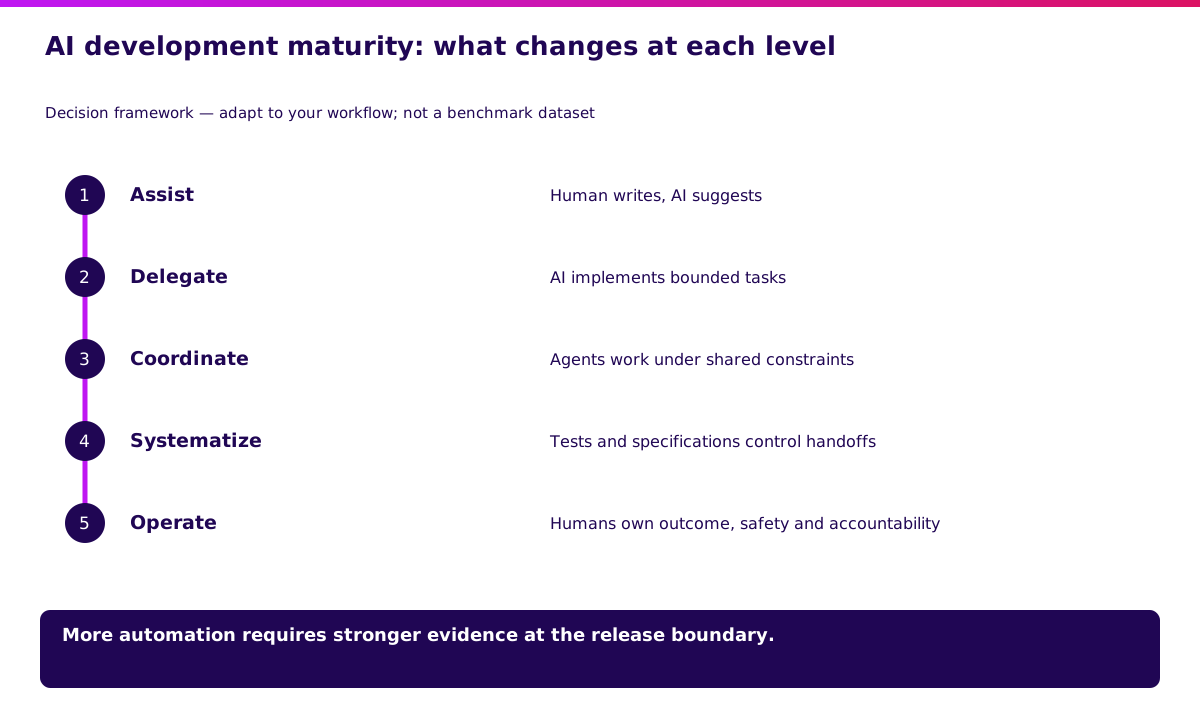
| Pola | Kontribusi AI | Tanggung jawab manusia |
|---|---|---|
| Assist | Memberi kandidat | Menulis dan memverifikasi perubahan |
| Delegate | Implementasi task terbatas | Menentukan kriteria dan mengecek hasil |
| Coordinate | Bekerja pada role agent eksplisit | Menyelesaikan konflik interface dan integrasi |
| Systematize | Menjalankan check berbasis specification | Mereview coverage, failure, dan risiko tersisa |
| Operate | Mendukung workflow delivery yang dimonitor | Memiliki release, security, recovery, dan outcome |
Pakai framework ini untuk bertanya siapa yang boleh menolak release dan berdasarkan evidence apa. Pendekatan Synetica menggabungkan implementasi terbatas, check berbasis specification, dan product acceptance oleh manusia.
Review ketujuh disiplin bersama.
Tujuh Disiplin Sekilas
| # | Disiplin | Apa yang Dicegah | Prinsip Kunci |
|---|---|---|---|
| 1 | Spec Adalah Produknya | Membangun hal yang salah | Pahami dulu sebelum membangun |
| 2 | Rencana Besar, Eksekusi Segar | Halusinasi dari context overflow | Context fokus per task; ukur error dan effort review |
| 3 | Test Dulu, Baru Kode | Output yang nggak teruji | AI nulis test dari spec DULU |
| 4 | Model Tepat, Tugas Tepat | Model overpowered yang overthink | Model pintar berpikir, model murah mengeksekusi |
| 5 | Potongan Kecil | Kegagalan berantai | Satu tugas, satu fitur, satu sesi |
| 6 | AI Review AI | Celah keamanan, anti-pattern | Manusia review produk, bukan kode |
| 7 | Spec sebagai Kontrak Hidup | Penyimpangan spec-kode | Blueprint dijaga sepanjang lifecycle |
Lanjut: Apa Artinya untuk Klien.
Apa Artinya untuk Klien
Kalau kamu klien yang membaca ini, inilah yang perlu kamu bawa:
Kamu bukan bayar untuk kode. Kode itu komoditas. AI mana pun bisa generate halaman login, dashboard, API. Yang kamu bayar adalah spesifikasinya — kepastian bahwa kami memahami masalahmu dengan benar dan akan membangun persis apa yang kamu butuhkan.
Kamu akan lihat spec-nya sebelum kode apa pun ada. Blueprint kami adalah deliverable, bukan dokumen internal. Kamu review. Kamu tantang. Kamu setujui. Baru setelah itu development dimulai.
Kualitas dibangun ke dalam proses, bukan ditempel di akhir. Kami nggak nulis kode terus cek apakah bagus. Kami definisikan dulu apa artinya “bagus,” generate test untuk itu, lalu generate kode yang lulus test-test itu.
Proyekmu bisa di-maintain oleh siapa pun. Karena Blueprint ada dan dijaga, developer mana pun (manusia atau AI) bisa memahami, memodifikasi, dan mengembangkan sistemmu. Kamu nggak pernah terkunci di satu vendor.
Lanjut: Apa Artinya untuk Developer.
Apa Artinya untuk Developer
Bantuan AI mengubah pekerjaan implementasi, tetapi tidak menghapus kebutuhan memahami sistem. Saya akan menilai developer dari kualitas keputusan dan evidence yang mereka bawa ke release.
| Skill | Kontribusi berguna | Evidence yang diperiksa |
|---|---|---|
| Discovery | Memahami workflow nyata dan constraint-nya | Problem statement terkait perilaku terbaru |
| Specification | Menentukan outcome, boundary, dan exception | Acceptance criteria yang bisa dites orang lain |
| Engineering | Membuat implementasi reliable dan maintainable | Test, recovery, access control, operating note |
| Communication | Membuka uncertainty sebelum menjadi rework | Trade-off jelas dan keputusan tercatat |
Skill apa yang mendukung delivery AI yang reliable?
Listening: minta operator menunjukkan task terbaru, termasuk titik gagalnya. Ubah constraint yang terlihat menjadi pertanyaan yang bisa diuji tim.
Writing: jelaskan behaviour yang dituju dan non-goal dengan presisi. Specification harus memberi developer maupun agent cara mengenali hasil yang salah.
Domain knowledge: pelajari record, exception, dan tanggung jawab pada bisnis yang kamu bantu. Teknologi saja tidak menentukan apakah return order harus membalik stok, revenue, atau keduanya.
Judgement: tentukan kapan evidence belum cukup. Eskalasi risiko security atau data ke reviewer yang kompeten; passing generated test belum menjadi persetujuan otomatis.
Mulai dari dua disiplin dan periksa hasilnya.
Mulai dari Sini
Kalau kamu mau mengadopsi pendekatan ini, jangan coba implementasi ketujuh disiplin sekaligus. Mulai dengan dua:
| Tahap adopsi | Yang ditambahkan | Yang bisa diabaikan dulu | Sinyal berhasil |
|---|---|---|---|
| Minggu 1 | Spec satu halaman sebelum code | Dokumentasi proses sempurna | Retry yang bingung berkurang |
| Minggu 2 | Sesi segar per task | Orkestrasi multi-agent | Diff lebih kecil dan bersih |
| Minggu 3 | Test dari spec | Coverage theater | Bug muncul sebelum release |
| Minggu 4 | Review AI terpisah | Review line-by-line manusia | Temuan spesifik dan bisa diperbaiki |
-
Tulis spec sebelum generate kode apa pun. Meskipun kasar. Meskipun cuma satu halaman. Tindakan menspesifikasi memaksamu berpikir sebelum membangun. Ini saja mengeliminasi setengah dari AI slop.
-
Gunakan sesi segar untuk setiap tugas. Berhenti pakai satu percakapan panjang. Pecah pekerjaanmu jadi tugas-tugas, mulai segar untuk masing-masing. Ini mengeliminasi polusi context yang menyebabkan halusinasi.
Dua disiplin ini, dipraktikkan secara konsisten, akan menghasilkan output yang terasa lebih baik dalam minggu pertamamu. Tambahkan yang lain seiring kamu nyaman.
Dan kalau kamu mau lihat seperti apa ini di skala besar — tim Product Strategist, masing-masing didukung AI replicant, mendelivery proyek lengkap dari spesifikasi sampai deployment tanpa menulis atau me-review satu baris kode pun — itulah yang sedang kami bangun di Synetica.
Kode bukan intinya. Memang nggak pernah.
Ganis Atmawarin adalah pendiri Synetica, konsultan bisnis berbasis teknologi di Yogyakarta, Indonesia. Sebelum memulai Synetica di 2026, dia menghabiskan 12 tahun di SoftwareSeni memimpin delivery software di Indonesia dan Australia. Dia masih belum bisa lari 5K tanpa berhenti, tapi sedang berusaha.
Evidence apa yang dibawa handoff task AI?
Test brief yang bisa diulang — input ilustratif, bukan hasil klien.
| Handoff | Input wajib | Output disimpan |
|---|---|---|
| Specification ke plan | Outcome, non-goal, failure case | Task terbatas dan acceptance check |
| Plan ke implementation | Interface dan test fixture | Perubahan code dan hasil check |
| Implementation ke owner | Check lolos dan risiko tersisa | Accept, revise, reject dengan alasan |
Bagaimana mengukur kualitas delivery AI?
Test brief yang bisa diulang — input ilustratif, bukan hasil klien.
| Ukuran | Aturan perbandingan | Batasan |
|---|---|---|
| Task lead time | Bandingkan task sejenis termasuk review | Token generated bukan delivery |
| Escaped defect | Definisi severity dan window sama | Sampel kecil bisa menyesatkan |
| Rework | Termasuk koreksi setelah acceptance | Draft cepat bisa menyembunyikan effort berikutnya |
Apa yang harus diperiksa release owner?
Test brief yang bisa diulang — input ilustratif, bukan hasil klien.
| Risiko | Check | Evidence release |
|---|---|---|
| Data hilang | Restore backup representatif | Record cocok dan waktu recovery |
| Failure akses | Tes role dan tenant boundary | Akses tanpa izin ditolak |
| Deployment buruk | Tes rollback dengan constraint migration | Recovery berfungsi dan owner jelas |
Lanjut: FAQ.
FAQ
Apa itu AI slop dalam software development?
AI slop adalah software yang digenerate cepat tanpa spesifikasi, testing, review, atau ownership yang cukup. Awalnya sering terlihat selesai, lalu jadi mahal ketika edge case, bug, dan intent yang tidak jelas menumpuk.
Apakah kode AI bisa production-ready?
Bisa, kalau sistem di sekitarnya ketat. Bagian pentingnya adalah Blueprint yang jelas, test sebelum implementation, tugas kecil, context segar, dan validasi outcome oleh manusia.
Apakah manusia masih perlu review kode AI?
Manusia perlu review produk, risiko, dan fit bisnisnya. AI bisa review kode terhadap checklist dan test, tapi manusia tetap memegang judgment apakah software-nya menyelesaikan masalah yang benar.
Apa langkah pertama untuk menghindari AI slop?
Tulis spec sebelum generate kode. Bahkan spec satu halaman berisi scope, user flow, edge case, dan acceptance criteria akan langsung mengurangi drift.
Bagaimana Synetica memakai AI di proyek software?
Synetica memakai AI untuk eksekusi, testing, dan review, sementara strategist manusia memegang discovery, spesifikasi, validasi, dan keputusan klien. Tujuannya delivery lebih cepat tanpa kehilangan kontrol.
Sumber
- METR: Early-2025 AI and Experienced Developer Productivity
- METR: February 2026 Experiment Design Update
- StrongDM: Software Factory
Artikel Terkait
Blueprint 2 Minggu · AI Development Company · Software Vendor Due Diligence
Dua minggu ke jawaban nyata
Butuh bantuan menerapkan ini?
Book sesi Blueprint dan kami ubah ide di artikel ini jadi prototype yang diuji ke user nyata—2 minggu, mulai 49jt.